
Introducción
Mientras los grandes hyperscalers acumulan miles de GPU para satisfacer la demanda creciente de inferencia en IA, Cerebras Systems toma el camino contrario. Con el CS-4, anunciado el 19 de agosto de 2026, la empresa californiana apuesta por una arquitectura radicalmente diferente: no un conjunto de componentes interconectados, sino tres obleas de silicio del tamaño de un plato, cada una grabada como un único procesador gigante.
La arquitectura wafer-scale: una apuesta sobre la física
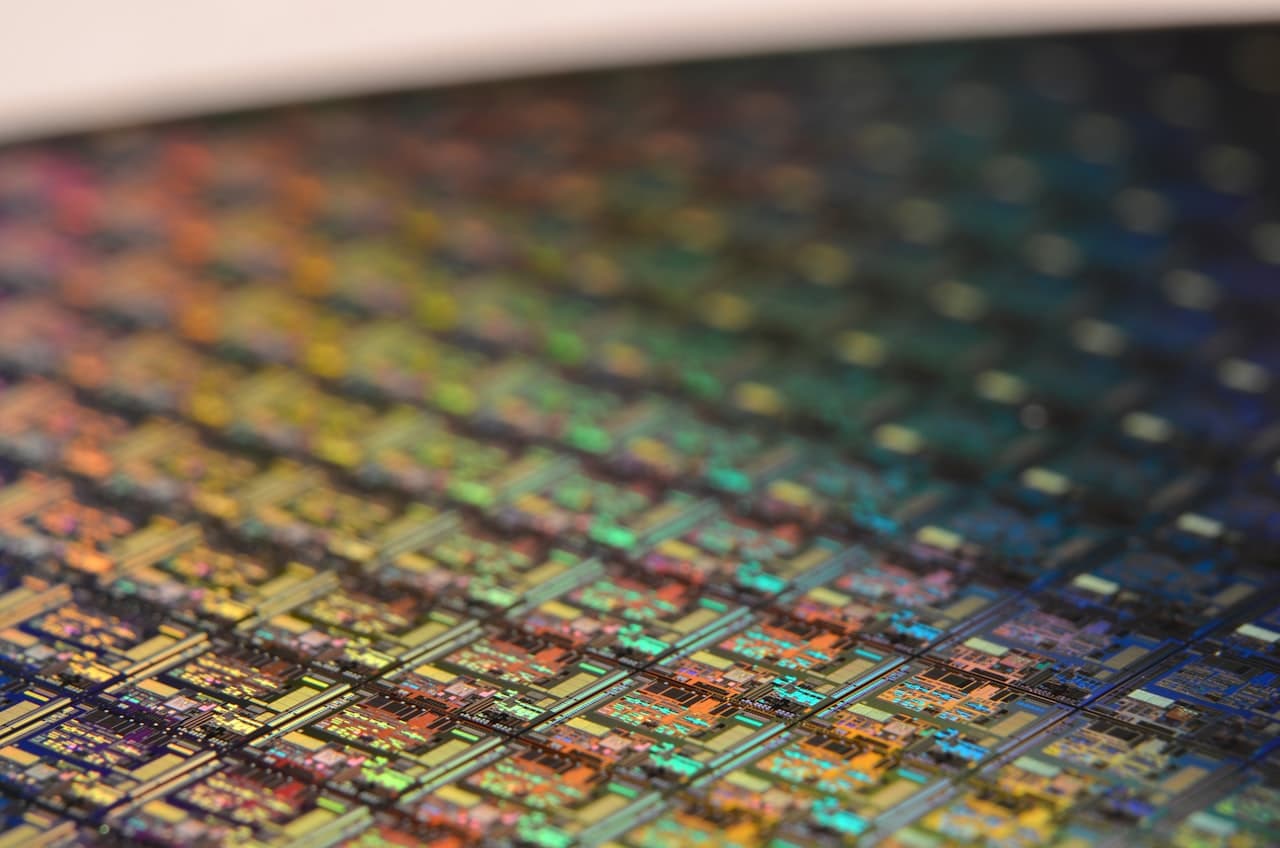
El núcleo del CS-4 descansa sobre tres unidades del Wafer Scale Engine 3 Turbo (WSE-3T). Cada chip ocupa 46 225 mm² de silicio —aproximadamente cincuenta veces la superficie de una GPU de gama alta— e integra 900 000 núcleos optimizados para el cómputo de IA, con un total de 4 billones de transistores por componente.
Esta elección arquitectónica no es solo una hazaña de ingeniería: responde a una restricción fundamental. En un clúster de GPU convencional, una proporción creciente del ancho de banda y la energía se consume no en el cálculo en sí, sino en el tránsito de datos entre componentes. El enfoque wafer-scale elimina en gran parte este cuello de botella: los 44 GB de SRAM están integrados directamente en cada oblea, con una latencia wafer-to-wafer que desciende a dos microsegundos en la nueva plataforma rack denominada Nexus.
Cifras que cambian la escala del mercado
El sistema CS-4 completo entrega 750 petaflops de cómputo de IA, 129,6 petaoctetos por segundo de ancho de banda de memoria y 7,2 terabits por segundo de rendimiento de entrada/salida. Cerebras anuncia hasta 30 veces más tokens producidos por segundo por usuario que soluciones GPU equivalentes, y una eficiencia energética diez veces superior a la del CS-3. El sistema está dimensionado para manejar modelos que superan los 50 billones de parámetros.
Para los equipos de infraestructura, otro indicador merece atención: la plataforma Nexus reduce a la mitad el número de componentes a desplegar y comprime el tiempo de instalación de varios días a pocas horas, gracias a un diseño modular que integra alimentación de alta densidad, refrigeración y control en un mismo chasis.
Una bifurcación en el diseño de aceleradores
Lo que ilustra el CS-4 va más allá del rendimiento en benchmarks. Señala una divergencia estructural en el diseño de aceleradores: por un lado, la vía de la escalabilidad horizontal impulsada por las GPU —añadir unidades, mejorar las interconexiones—; por otro, la vía de la densidad monolítica —concentrar más cómputo en una superficie continua de silicio, sin las fricciones del diseño multi-chip.
Cerebras también ha forjado una alianza con AMD en torno a una arquitectura de inferencia desagregada: AMD Helios gestiona la fase de Prefill, mientras el CS-4 se encarga del Decode. La ganancia de rendimiento combinada anunciada alcanza cinco veces la de una solución mono-proveedor, lo que abre la puerta a configuraciones híbridas inéditas en los centros de datos.
Las primeras entregas comerciales están previstas para este trimestre (Q3 2026), lo que permitirá contrastar pronto las afirmaciones de rendimiento con cargas de trabajo en producción real.
Implicaciones para los CIOs
El CS-4 representa menos una solución universal que una señal sobre la evolución del mercado de aceleradores. La competencia ya no se libra únicamente en FLOPS brutos: la latencia de memoria, la densidad de cómputo por rack y el consumo energético total se convierten en criterios decisivos. El hecho de que una sola plataforma muestre avances significativos en estas tres dimensiones simultáneamente invita a reconsiderar las arquitecturas de inferencia planificadas para 2027, antes de que los próximos ciclos de renovación de hardware consoliden decisiones de infraestructura por varios años.