Introducción
Durante años, la infraestructura de red de los proyectos de IA se concentró en un único desafío: interconectar las GPU a la mayor velocidad posible dentro del datacenter. Las inversiones masivas de los hyperscalers en fabrics InfiniBand y Ethernet a 400G u 800G son la expresión más visible de esta lógica conocida como «scale-out». Pero se perfila otra batalla, menos espectacular en apariencia aunque igualmente decisiva para las organizaciones que despliegan cargas de inferencia: la distribución geográfica de esos workloads y las redes WAN que esta implica. Es precisamente esta frontera la que Arista Networks eligió para sus anuncios del 17 de noviembre de 2026 en SC26.
De la GPU farm al edge: un cambio de topología
La inferencia IA concentrada en unos pocos grandes datacenters respondía a una arquitectura relativamente clara: clústeres GPU hiperconectados, un perímetro de red bien delimitado y latencias aceptables para la mayoría de los casos de uso. La irrupción de los agentes de IA autónomos complica considerablemente esta ecuación.
Un agente que encadena múltiples llamadas a modelos, para razonar, consultar herramientas externas y generar una respuesta, acumula tiempos de tránsito en cada paso. Si esos intercambios pasan por un datacenter remoto, los milisegundos se suman y degradan la experiencia en tiempo real. La tendencia, por tanto, apunta a acercar el cómputo de inferencia a los usuarios finales: sitios remotos, puntos de presencia regionales, infraestructura próxima a las antenas 5G. A esto se suman restricciones de soberanía que, en varios países, obligan a que los datos permanezcan dentro de perímetros geográficos definidos.
Esta dispersión redefine la restricción de red. Ya no basta con gestionar el ancho de banda interno del datacenter: lo que importa ahora es la calidad, la fiabilidad y la coherencia del transporte entre nodos de inferencia.
Lo que Arista anunció en SC26
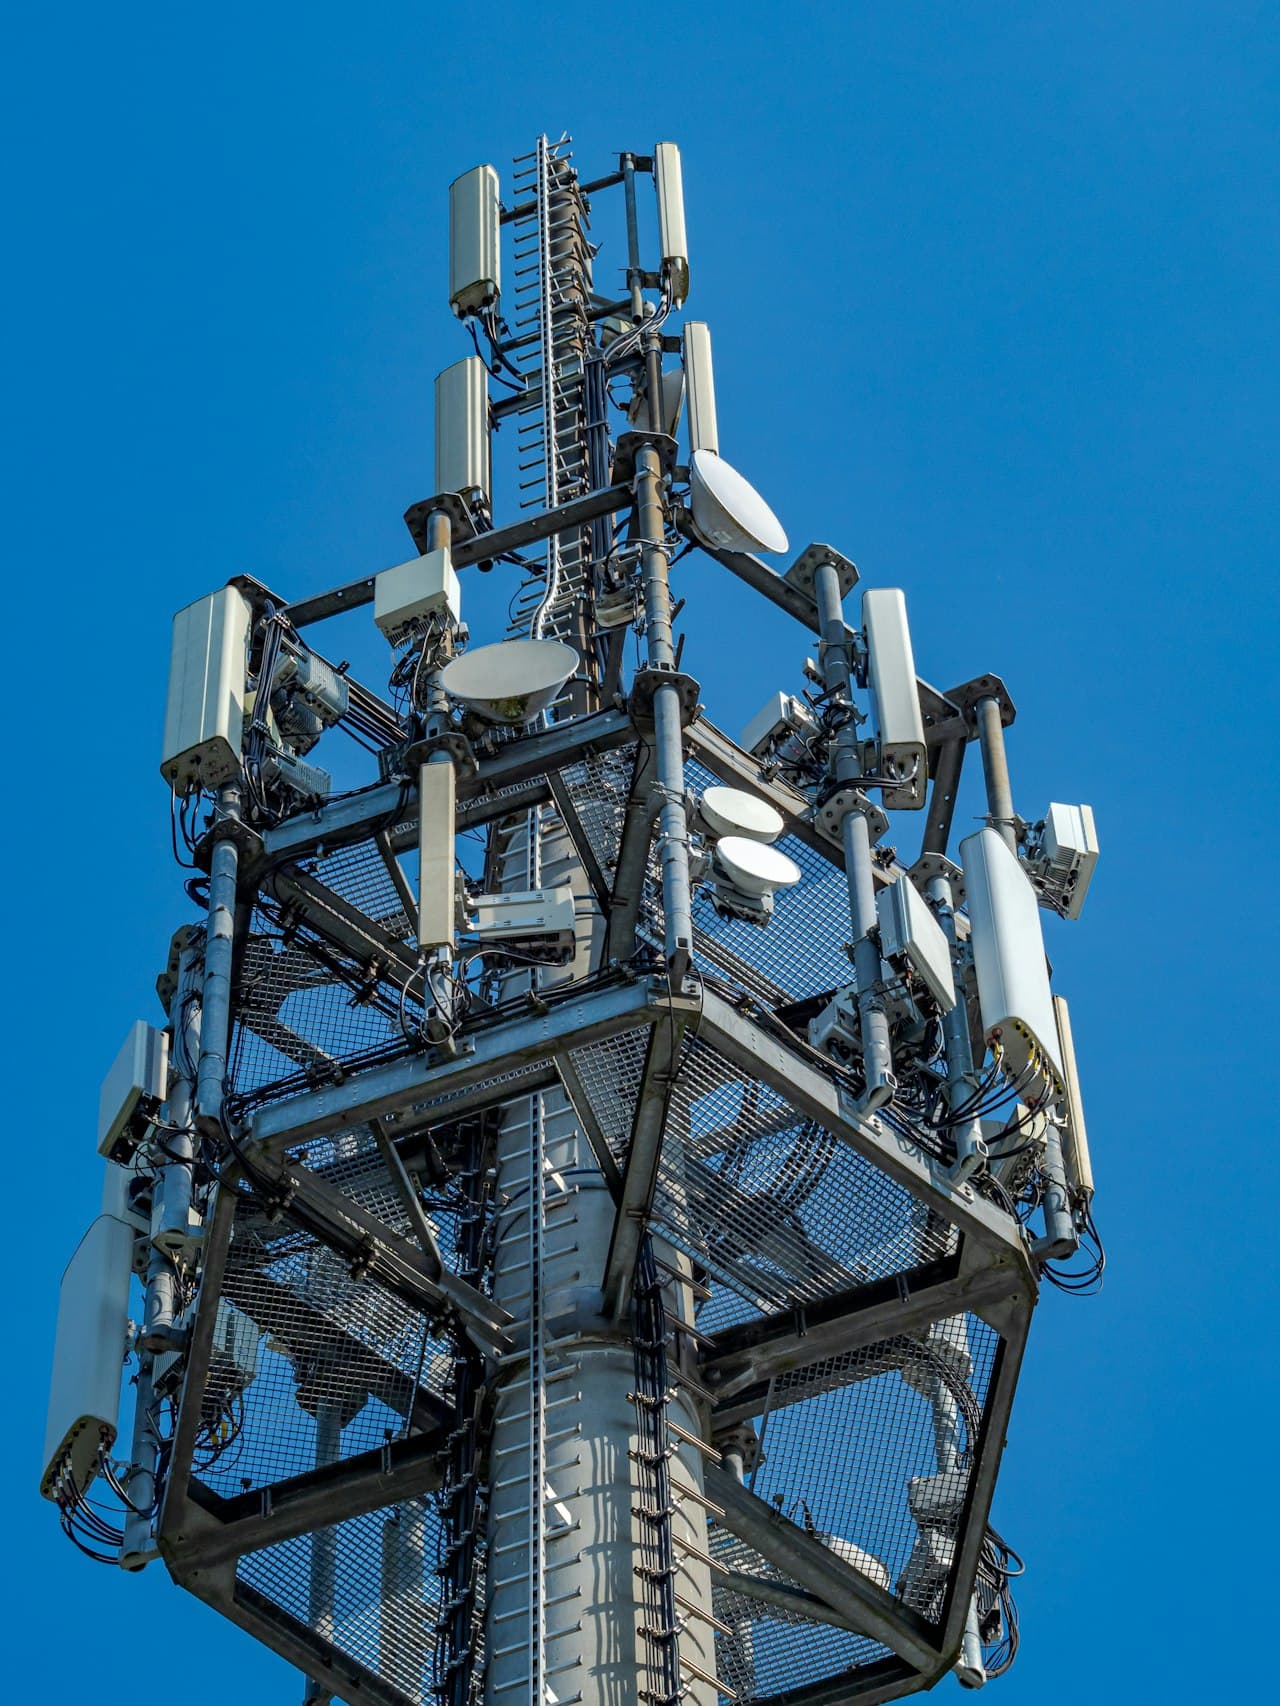
La familia Etherlink R4 consta de cuatro plataformas, cada una orientada a un eslabón específico de esta topología distribuida. Los modelos 7020R4 y 7020HR4 son routers de acceso compactos en 1 RU, compatibles con puertos de 25G a 400G. La variante HR4 está reforzada térmicamente para despliegues en entornos exteriores, especialmente cerca de emplazamientos 5G, con disponibilidad prevista para principios de 2027; el 7020R4 ya está disponible.
El 7282R4 apunta a los nodos de núcleo y borde con dos supervisores redundantes para garantizar la disponibilidad del plano de control en puntos de peering críticos. El 7280R4, pieza clave del transporte de larga distancia, ofrece según Arista una capacidad de 25,6 Tbps con 64 puertos 400G, la mitad de los cuales admiten ópticas coherentes ZR/ZR+ para enlaces entre sitios.
Arista destaca una reducción del consumo energético de hasta un 60 % frente a plataformas competidoras basadas en silicio de 7 nm y 16 nm. Estos equipos integran MACsec e IPsec en hardware, enrutamiento por segmentos SRv6 y sincronización de red de precisión: capacidades nativas, no añadidas como capas de software.
Un mercado que se articula en torno al «scale-across»
La convergencia entre redes de operadores, edge computing e infraestructura IA está configurando un segmento que los fabricantes empiezan a denominar «scale-across», por oposición al «scale-out» propio de los clústeres GPU. Arista señala que este segmento representa ya alrededor del 30 % de sus actividades en infraestructura IA, con un potencial de mercado que estima entre tres y cuatro mil millones de dólares a escala mundial.
Para los CIO y responsables de infraestructura, la señal es inequívoca: los próximos proyectos de inferencia no se limitarán a aprovisionar GPU y ancho de banda en el datacenter. Exigirán una reflexión sobre la topología de transporte entre sitios, la coherencia de las políticas de enrutamiento en entornos multi-fabricante y el control de la latencia extremo a extremo en arquitecturas distribuidas. Los operadores de telecomunicaciones y los integradores especializados en redes corporativas tienen todo el interés en posicionarse en este segmento sin demora: la inferencia IA distribuida ya no es una hipótesis de laboratorio; está en pleno despliegue.