
Introduction
Pendant que les hyperscalers empilent des milliers de GPU pour répondre à la demande en inférence IA, Cerebras Systems prend le chemin inverse. Avec le CS-4, annoncé le 19 août 2026, l'entreprise californienne mise sur une architecture radicalement différente : non pas une grappe de composants interconnectés, mais trois tranches de silicium de la taille d'une assiette, chacune gravée comme un seul et unique processeur géant.
L'architecture wafer-scale, un pari sur la physique
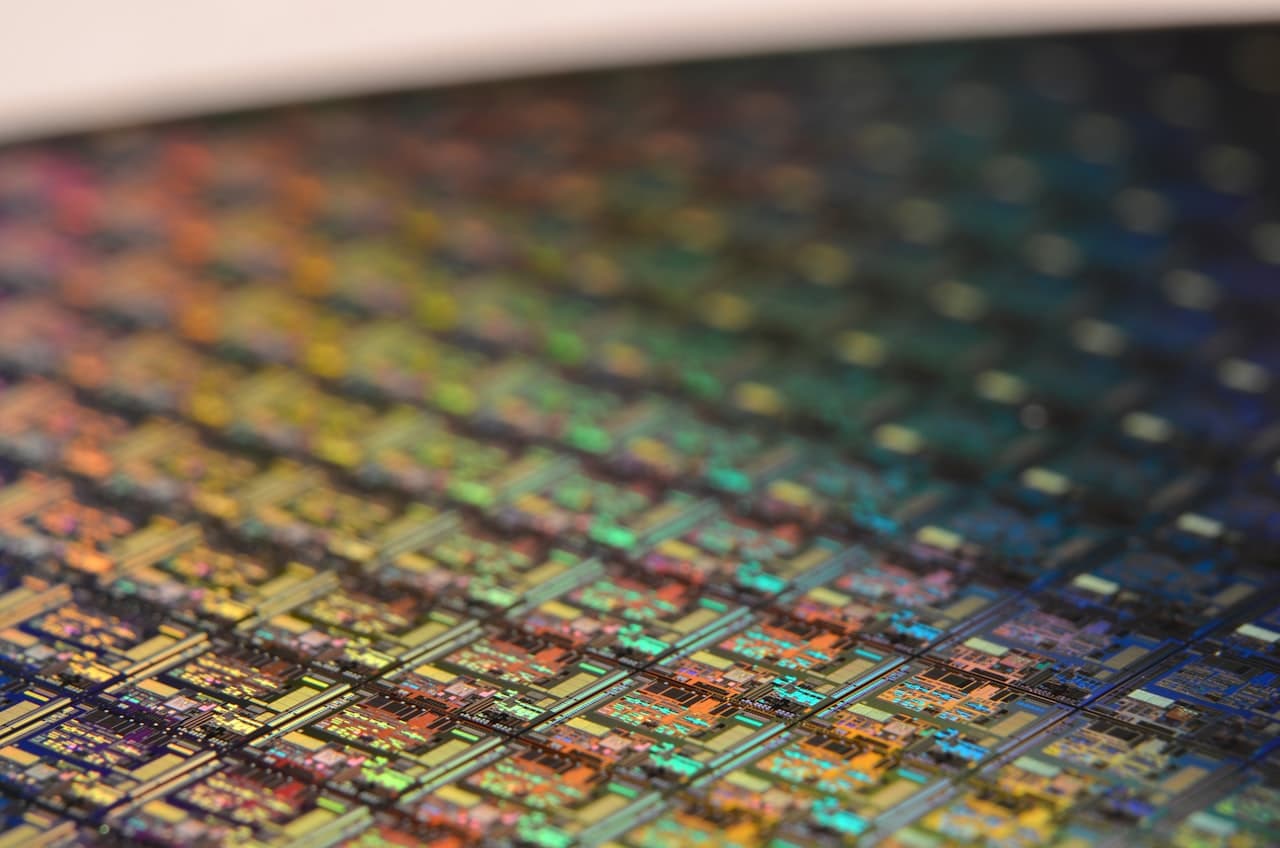
Le cœur du CS-4 repose sur trois exemplaires du Wafer Scale Engine 3 Turbo (WSE-3T). Chaque puce occupe 46 225 mm² de silicium — soit environ cinquante fois la surface d'un GPU haut de gamme — et intègre 900 000 cœurs optimisés pour le calcul IA, pour un total de 4 billions de transistors par composant.
Ce choix architectural n'est pas uniquement une prouesse d'ingénierie : il répond à une contrainte fondamentale. Dans un cluster GPU classique, une fraction croissante de la bande passante et de l'énergie est consommée non pas par le calcul lui-même, mais par le transit des données entre les composants. L'approche wafer-scale élimine en grande partie ce goulot d'étranglement : les 44 Go de SRAM sont intégrés directement dans chaque tranche, avec une latence wafer-to-wafer descendant à deux microsecondes sur la nouvelle plateforme rack baptisée Nexus.
Des chiffres qui changent d'échelle
L'ensemble du système CS-4 délivre 750 pétaflops de calcul IA, 129,6 pétaoctets par seconde de bande passante mémoire et 7,2 térabits par seconde de débit d'entrée/sortie. Cerebras annonce jusqu'à 30 fois plus de tokens produits par seconde par utilisateur que des solutions GPU équivalentes, et une efficacité énergétique dix fois supérieure à celle du CS-3. Le système est dimensionné pour traiter des modèles dépassant 50 billions de paramètres.
Pour les équipes d'infrastructure, un autre indicateur mérite attention : la plateforme Nexus réduit de moitié le nombre de composants à déployer et compresse le délai d'installation de plusieurs jours à quelques heures grâce à un design modulaire intégrant alimentation haute densité, refroidissement et contrôle dans un même châssis.
Une bifurcation dans la conception des accélérateurs
Ce que le CS-4 illustre dépasse les seules performances de benchmark. Il signale une divergence structurelle dans la conception des accélérateurs : d'un côté, la voie de la scalabilité horizontale portée par les GPU — ajouter des unités, améliorer les interconnexions ; de l'autre, la voie de la densité monolithique — faire tenir davantage de calcul sur une surface continue de silicium, sans les frictions du multi-chip.
Cerebras a également noué un partenariat avec AMD autour d'une architecture d'inférence disaggregée : AMD Helios prend en charge la phase Prefill, le CS-4 gère le Decode. Le gain de débit combiné annoncé atteint cinq fois celui d'une solution mono-fournisseur, ce qui ouvre la voie à des configurations hybrides inédites dans les datacenters.
Les premières livraisons commerciales sont prévues pour ce trimestre (Q3 2026), ce qui permettra bientôt de confronter les revendications de performance à des charges de production réelles.
Ce que cela implique pour les DSI
Le CS-4 représente moins une solution universelle qu'un signal sur l'évolution du marché des accélérateurs. La compétition ne se joue plus uniquement sur les FLOPS bruts : la latence mémoire, la densité de calcul par rack et la consommation énergétique totale deviennent des critères décisifs. Le fait qu'une seule plateforme affiche des gains marqués sur ces trois dimensions simultanément invite à reconsidérer les architectures d'inférence planifiées pour 2027 — avant que les prochains cycles de renouvellement matériel ne figent des choix d'infrastructure pour plusieurs années.