Introduction
Depuis cinq ans, déployer de l'infrastructure IA à grande échelle signifiait, dans les faits, négocier avec un seul fournisseur. L'écosystème NVIDIA — DGX, HGX, NVLink, CUDA — a imposé ses propres règles aux acheteurs, des hyperscalers aux DSIs d'entreprises industrielles. Le 30 septembre 2026, une commande de 1,2 milliard de dollars passée par Vultr à HPE vient changer cette équation : c'est le premier déploiement commercial de l'AMD Helios AI Rack, une plateforme rack-scale entièrement intégrée qui prétend concurrencer l'empire vert sur son propre terrain.
Un rack pensé comme un système, pas comme un empilement de composants
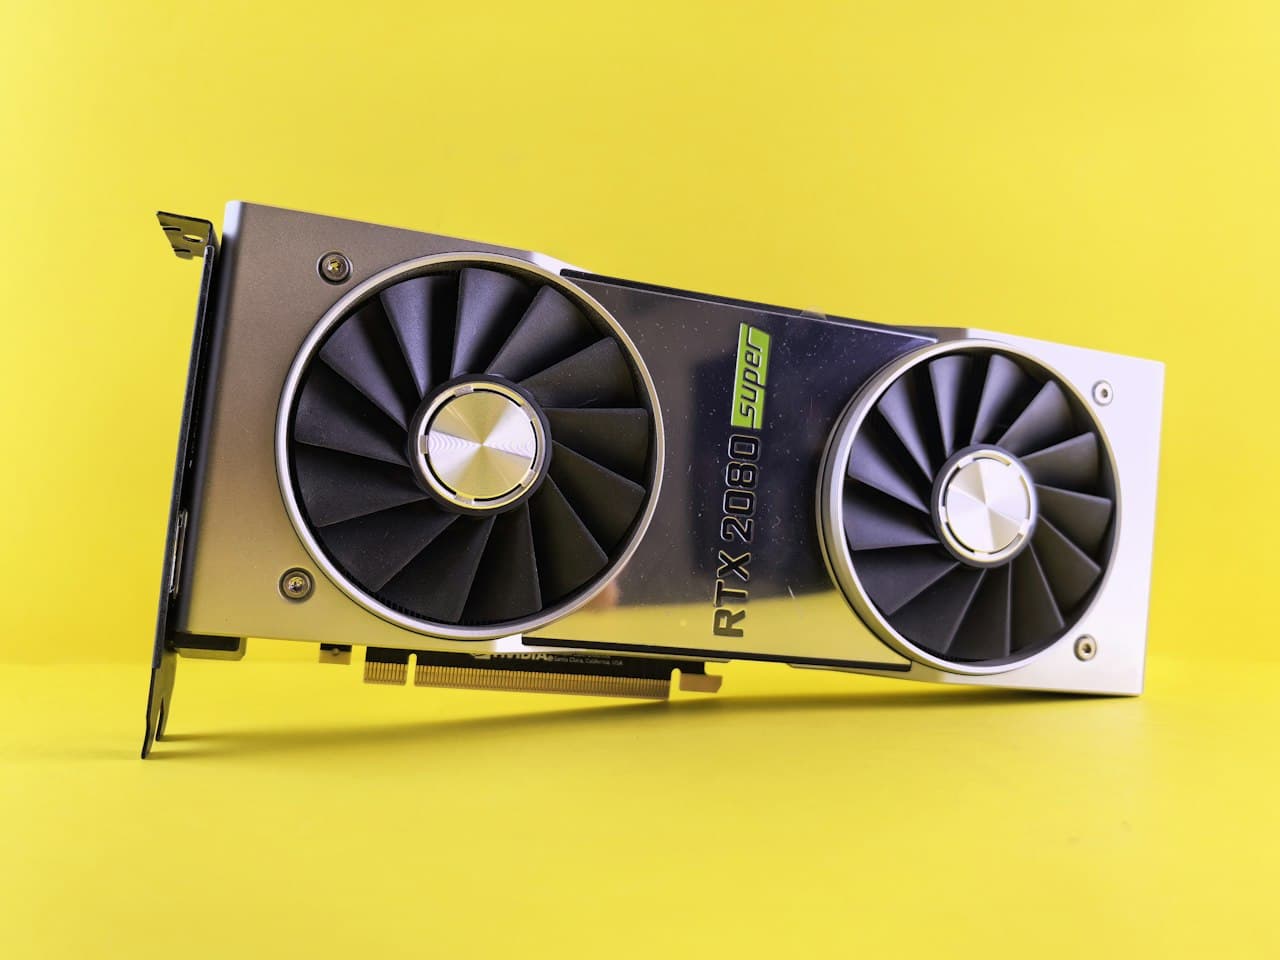
Ce qui singularise l'AMD Helios n'est pas seulement la puissance brute de ses accélérateurs — bien qu'elle soit réelle. Chaque rack intègre 72 GPU AMD Instinct MI455X, construits sur l'architecture CDNA 5 gravée en 2 nanomètres chez TSMC, avec 432 Go de mémoire HBM4 et 23,3 To/s de bande passante mémoire par puce. La densité de calcul par rack atteint 1,4 ExaFLOPS en FP8, pour un total de 31 To de HBM4 mis en pool.
Mais la philosophie Helios va au-delà du silicium. Les processeurs serveur AMD EPYC Venice — première puce x86 de production en volume sur le nœud 2 nm de TSMC — gèrent l'orchestration locale. Les cartes réseau AMD Pensando Vulcano prennent en charge le fabric. Le switch HPE Juniper Networking QFX5252 assure l'interconnexion inter-racks. L'ensemble est refroidi en intégral liquide. Ce n'est plus un assemblage de composants à intégrer soi-même : c'est une unité livrable, qualifiée, supportée.
HPE joue ici le rôle d'intégrateur de référence en s'appuyant sur son acquisition de Juniper Networks pour couvrir l'ensemble de la stack réseau-compute. La logique concurrentielle est directe : en face, NVIDIA propose ses DGX SuperPOD selon le même modèle packagé. AMD répond désormais avec la même proposition, et un partenaire de distribution qui pèse.
Ce que la première commande commerciale révèle
La taille du contrat — 1,2 milliard de dollars, pour des déploiements dans les datacenters américains de Vultr — est un signal fort pour l'ensemble du marché. Elle signifie qu'un cloud provider de taille intermédiaire a évalué l'écosystème AMD Helios comme suffisamment mature pour un déploiement en production, et a décidé de ne pas attendre. C'est précisément le type de validation que les grands opérateurs et les DSIs d'entreprise guettent avant de diversifier leurs fournisseurs.
Un point mérite l'attention des équipes infrastructure : l'AMD Helios repose sur des standards ouverts pour l'interconnexion GPU, là où NVIDIA s'appuie sur son NVLink propriétaire. Cette architecture ouverte, si elle tient en environnement de production intensif, modifie structurellement les leviers de négociation des acheteurs et réduit le risque de dépendance unilatérale à long terme.
Ce que les DSIs doivent en retenir
Pour les équipes qui planifient des investissements en infrastructure IA à horizon 2027, cette première livraison commerciale a trois implications concrètes. D'abord, une alternative rack-scale à NVIDIA existe désormais hors du communiqué de presse. Ensuite, HPE s'affirme comme intégrateur capable de porter l'ensemble du cycle — de la conception à la mise en production, support inclus. Enfin, la présence d'un second écosystème viable dans les appels d'offres redonne des marges de manœuvre sur les prix et les délais de livraison.
La vraie inconnue reste l'écosystème logiciel : compilateurs, bibliothèques, support des frameworks ML comme PyTorch ou JAX. NVIDIA a mis dix ans à construire la domination de CUDA. AMD avance sur ROCm, mais l'hégémonie logicielle se conquiert différemment que le silicium. Pour les DSIs, c'est là que se joue la décision finale — et les prochains trimestres de retours terrain de Vultr seront déterminants.